


gpt-image-1 outpaint 시 원본 복제 아티팩트 & 경계 접선 불일치 — 해결 방법이 있을까요?
안녕하세요. 도움이 필요해서 이렇게 올리게 되었습니다 ㅠㅠ
현재 저는 광고회사 개발자로 광고 배너 자동 리사이징 파이프라인을 개발 중입니다.
원본 PSD/PNG/JPG (1200×628)를 여러 광고 규격으로 자동 변환하는데, gpt-image-1의 images.edit API를 활용해 빈 영역을 AI로 채우고 있습니다.
현재 문제점은 아래와 같습니다.
문제1 - 원본 경계에서 접선 방향 불일치.
문제2 - 세이프존 모드에서 원본 요소 복제.
혼자서 방향을 달리 해서 계속 시도 해보고 있는데.. 딱히 그렇다할 성과는 못 얻고 있는 상황입니다.
긴 글을 읽어 주셔서 감사드리고 한번씩 꼭 읽어봐주시길 부탁드립니다.
구현 방식 (TYPE D 파이프라인)
- 원본을 축소해서 목표 캔버스 중앙에 배치. (비율 유지)
- 빈 영역 마스크 생성 → 확장해야될 영역을 openai통해서 자연스럽게 배경 생성 하라고 지시.
- 원본 복원 + feather alpha blend로 경계 자연스럽게 처리
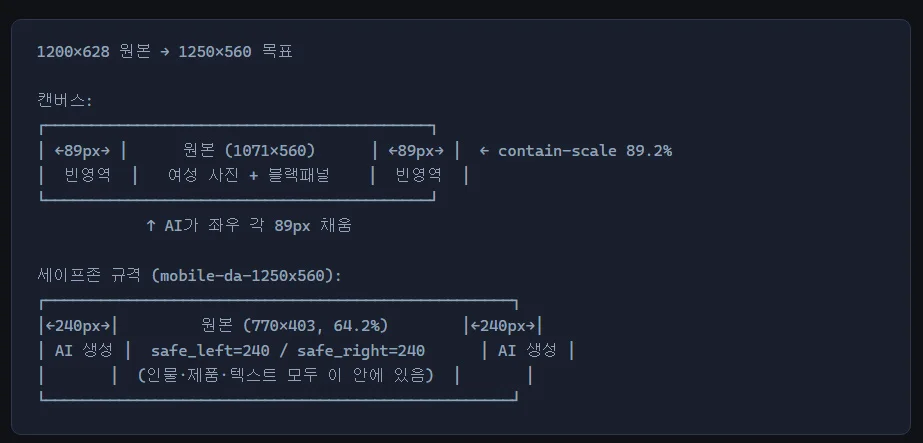
🔴 문제 1 — 원본 경계에서 접선 방향 불일치
1200×628 → 1250×560 변환 시 좌우 각 89px 빈 영역이 발생합니다.
원본 이미지의 좌측 경계에는 흰색 새틴 천이 있고, AI가 그 곡선을 자연스럽게 이어야 합니다.
하지만 AI가 경계에서 천의 접선 방향(주름 흐름)을 제대로 추론하지 못하고 어색하게 이어집니다.
* 원본 좌측에 단일 배경이 아닌 흰색 천이 있는 사진입니다!
시도한 것들
- 마스크를 원본 안쪽 40px까지 확장 → AI가 경계 픽셀을 더 많이 볼 수 있도록
- 좌측 먼저 생성 후 우측 입력으로 사용하는 sequential 처리
- v1~v10 프롬프트 반복 튜닝 ("satin fabric", "tangent lines", "natural arc" 등)
- 80px, 120px으로 확장 늘려보기 → 경계가 넓어질수록 우측 텍스트 영역 침범
→ 40px 확장 + feather blend가 현재 가장 나은 결과이지만, 접선 방향 일치는 여전히 불완전합니다.
🔴 문제 2 — 세이프존 모드에서 원본 요소 복제
세이프존 규격에서는 원본이 64%로 축소되어 좌우 각 240px, 상하 ~80px의 빈 영역이 생깁니다.
배경만 채워야 하는데, AI가 원본의 얼굴·제품·한국어 텍스트를 그대로 복제합니다.
시도한 것들
- 프롬프트에 "do not duplicate, mirror, or recreate any element from the center" 추가
- "ABSOLUTE PROHIBITIONS" 섹션으로 금지 항목 명시 강화
- 마스크 안쪽 확장 비활성화 (원본 경계 침범 차단)
→ 개선되었지만 여전히 부분 복제가 발생합니다. 확장 영역이 240px로 넓어서 AI가 "큰 그림"을 새로 그리는 방식으로 동작하는 것 같습니다.
댓글 2개
이미지 생성 에서 추론이 약하다면, gpt-image2 를 쓰면 되지 않을까요?
비용 이외에 gpt-image1 을 꼭 써야 할 이유가 있나요?
만약 figma 로 이 작업을 쉽게 수행할수 있다면, figma mcp 를 연동후 skills 를 만들어 구현하는게 더 좋을수도 있습니다.
백엔드 서버에 figma mcp 서버 + codex desktop(또는 claude desktop) 을 설치후 queue 작업을 처리하는 기능을 추가하여 스케쥴 작업(1분에 한번 수행 등) 방식으로 만드는 방법이나, comfyui 로 워크플로우 생성 + n8n 워크 플로우(웹훅등) 연동 방법.
단순히 gpt image api 로 한번에 생성이 안되는건 여러 다른 방법을 시도 해보는게 좋을것 같습니다.
https://fal.ai/dashboard 에 보면 image edit 기능을 제공하는 여러 모델이 있습니다. 여러 모델중에서 원하는 기능을 가장 효과적으로 수행하는 모델이 있는지 테스트 해보세요.
그외 여러 방법이 있을것 같은데, 원본 이미지 -> 생성 이미지 예제를 알수 없어서 이정도로만 답변 드립니다.
ps) 추가로 광고 배너라면, 배너 이펙트 효과가 있다고 가정하면, 이를 구현하기 위해서는 figma mcp 나 after effect(혹은 포토샵) 의 모션 기능과 연동후 생성하는것도 고려해볼만합니다.
모든것은 AI로 해결하려고 하지 마시고
적절한 조화를 통해서 해결하면 오히려 답이 보일수도 있습니다.
AI가 담당할 영역과 기존과 같이 프로그래밍으로 해결할 영역을 적절히 잘 섞어서
의외로 괜찮은 결과가 나올때도 있더라구요!!
특히 이미지 및 3D 모델링 같은경우는 AI가 짜잔 하고 정확한 해결책을 제시하지 못하는 경우가 많더라구요!!